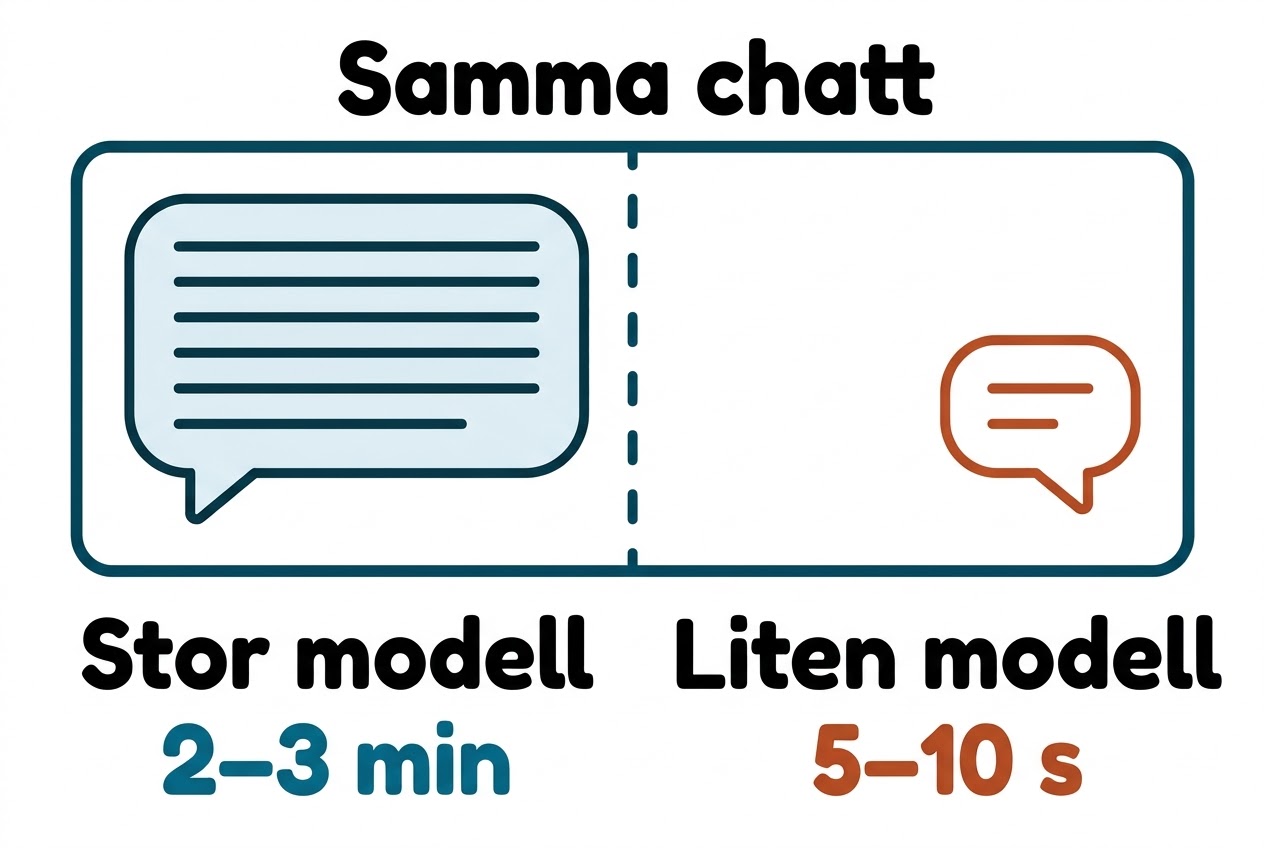
Samma chatt kan byta till en enklare modell utan att säga till. Det märks på att svaren kommer snabbare och blir allmännare.
Häromdagen upptäckte jag att svaren i en chat jag jobbade i helt plötsligt ändrade karaktär, under tiden jag satt och skrev. Utan förvarning började svaren plötsligt bli betydligt mer generella, och de kom dessutom betydligt snabbare. Mina tidigare frågor och uppgifter hade tagit ca 2-3 minuter för AI-modellen att svara på, till att plötsligt bara ta ca 5-10 sekunder innan jag fick svar.
Min första misstanke var att mina egna frågor hade blivit lättare att svara på. När det inte verkade stämma tänkte jag istället att jag fått någon automatisk uppgraderad version av min prenumeration, alltså någon form av erbjudande att gratis testa en mer effektiv AI-modell. Tyvärr verkade förklaringen vara raka motsatsen, att svaren gick snabbare eftersom leverantören i hemlighet hade bytt över min AI-chat till att använda en enklare AI-modell. Lite som att du bett en erfaren kollega om hjälp och fått svar från en nyanställd istället, utan att någon sa till.
Varje AI-chatt kan ha flera modeller
De flesta AI-leverantörer har flera AI-modeller att välja mellan, se exempel i Tabell 1.
Tabell 1. Några av modellerna hos de vanligaste AI-leverantörerna (aktuell september 2026).
| ChatGPT | Claude | Gemini | SveaGPT |
|---|---|---|---|
| Astra | Opus | Pro | Mistral |
| Sol | Sonnet | Thinking | Llama |
| Luna | Haiku | Flash |
De större och mer kraftfulla modellerna (exempelvis Astra och Opus) ger bättre svar men är långsammare och dyrare att köra för leverantören (på AI-språk säger man att varje prompt kostar mer “tokens”). De mindre och enklare modellerna svarar snabbare, men svaren blir också mer allmänna och mindre användbara. Eftersom olika modeller kostar olika mycket att köra begränsar leverantörerna användningen av de bästa modellerna utifrån hur mycket du betalar för tjänsten. Detta gäller speciellt för gratisversionerna som, åtminstone sett till pris, är gratis. I vissa fall kan du som användare fritt välja vilken modell du vill utgå ifrån, i andra fall väljer leverantören det åt dig beroende på vad du frågar. Det är därför svaren kan bli sämre och snabbare på samma gång: när gränsen är nådd ställer en del tjänster om din chat till en enklare modell. Det var detta som hände mig.
Hur tydligt skiftet av AI-modellen syns skiljer sig mycket mellan tjänsterna. I Claude kan du exempelvis med enkelhet se vilken modell som svarar, och hur mycket tokens (alltså data) du har kvar att använda, se Figur 1. När förbrukningen når 100% slutar AI-tjänsten helt att fungera tills dess att användningsfönstret blivit återställt (i skrivande stund per 5-timmar och per vecka).
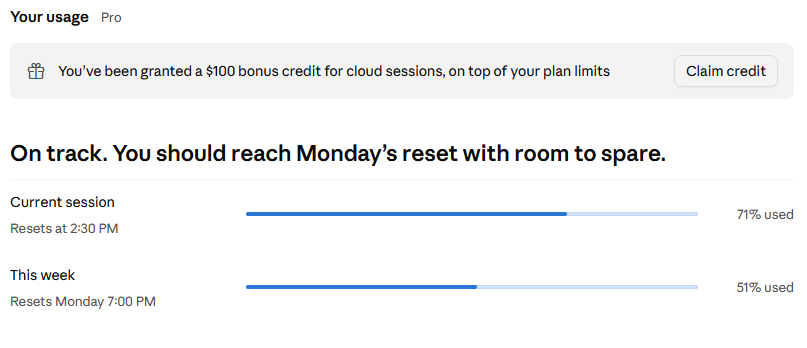
Figur 1. En översiktlig exempelbild över hur mycket tokens min AI-användning idag har kostat. Min egen prenumeration begränsar användningen per 5-timmar (i detta exempel 71%), och per vecka (51%).
I Gemini är det svårare att se hur mycket tokens du använt, och hur mycket du har kvar. Här blir istället modellerna (exempelvis "Pro") gråmarkerade, samtidigt som tjänsten byter förvald modell i chattfönstret. Det syns, men bara om du tittar efter det. Se Figur 2.
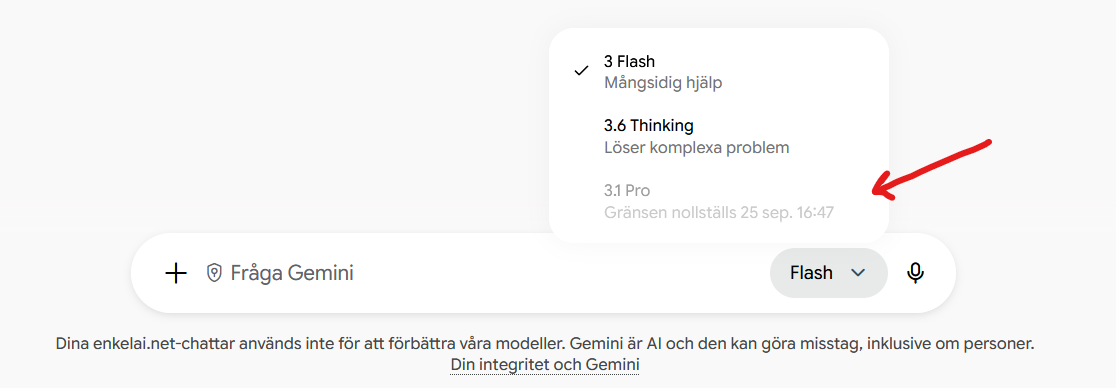
Figur 2. Ett exempel på hur det kan se ut när Gemini begränsar åtkomsten till den mer avancerade modellen “3.1 Pro” efter en stunds intensiv användning.
Problemet är att en del tjänster inte visar vilken modell som svarar, ej heller om den byts ut mot en enklare modell när du ställer frågor.
Gör så här om din AI-modell ändrar beteende
Att svaren varierar lite från gång till gång är normalt, det såg vi redan i AI är ingen sökmotor. Men om svaren plötsligt blir tydligt sämre eller mer generella, och dessutom kommer betydligt snabbare än vanligt, är det värt att reflektera över vad anledningen kan vara. Speciellt om dina typer av frågor inte har ändrats.
Här är några saker du kan kontrollera, med bakomliggande anledning:
Dubbelkolla inställningarna. Titta i modellväljaren om modellen har bytts ut i smyg, eller om den du brukar använda är gråmarkerad. Ofta finns detta val direkt i chat-rutan (dvs. där du skriver dina promptar).
Vänta en stund och fråga igen. Avvakta till exempel 20 minuter och ställ samma prompt igen. Blir svaret bättre har du troligen slagit i en gräns och tjänsten har haft en sorts cool-down-tid.
Fråga modellen själv, men se svaret som en ledtråd. I linje med att behandla AI-modellen som en kollega kan du alltid fråga den själv varför svaren plötsligt är annorlunda. Kom bara ihåg att din chat sällan kan se hur leverantören har valt modell, så förklaringen kan ibland bli en efterkonstruktion.
Fråga den som ansvarar för tjänsten. Använder du en AI-tjänst via jobbet och inte kan se vilken modell som svarar, kan du alltid fråga den som är ansvarig för avtalet. Ofta är det någon chef eller personal på IT-avdelningen.
Ett praktiskt tips på hur du kan träna dig att se problemet
Öppna det AI-verktyg du brukar använda och leta upp inställningen för vilken modell som svarar. Ofta står detta direkt där du skriver chatten. Ställ sedan en fråga du har ställt tidigare, gärna en som kräver lite eftertanke av modellen. Lägg märke till hur snabbt och hur utförligt svaret kommer. Starta därefter en ny chat, byt modell och ställ samma fråga en gång till. Genom att jämföra svaren mellan de två AI-modellerna kommer du ha lättare att märka när något ändras även i framtiden.
Förhoppningsvis är det nu lite enklare att förstå varför dina AI-svar plötsligt blir sämre.
Har du frågor eller invändningar? Mejla mig gärna. Fler artiklar publiceras efterhand.
Lycka till!